AI Speaker Separation
使用AI说话人分离技术,将播客、采访、会议或视频音频按说话人分离成独立的音轨。预览并下载WAV文件。免费试用。
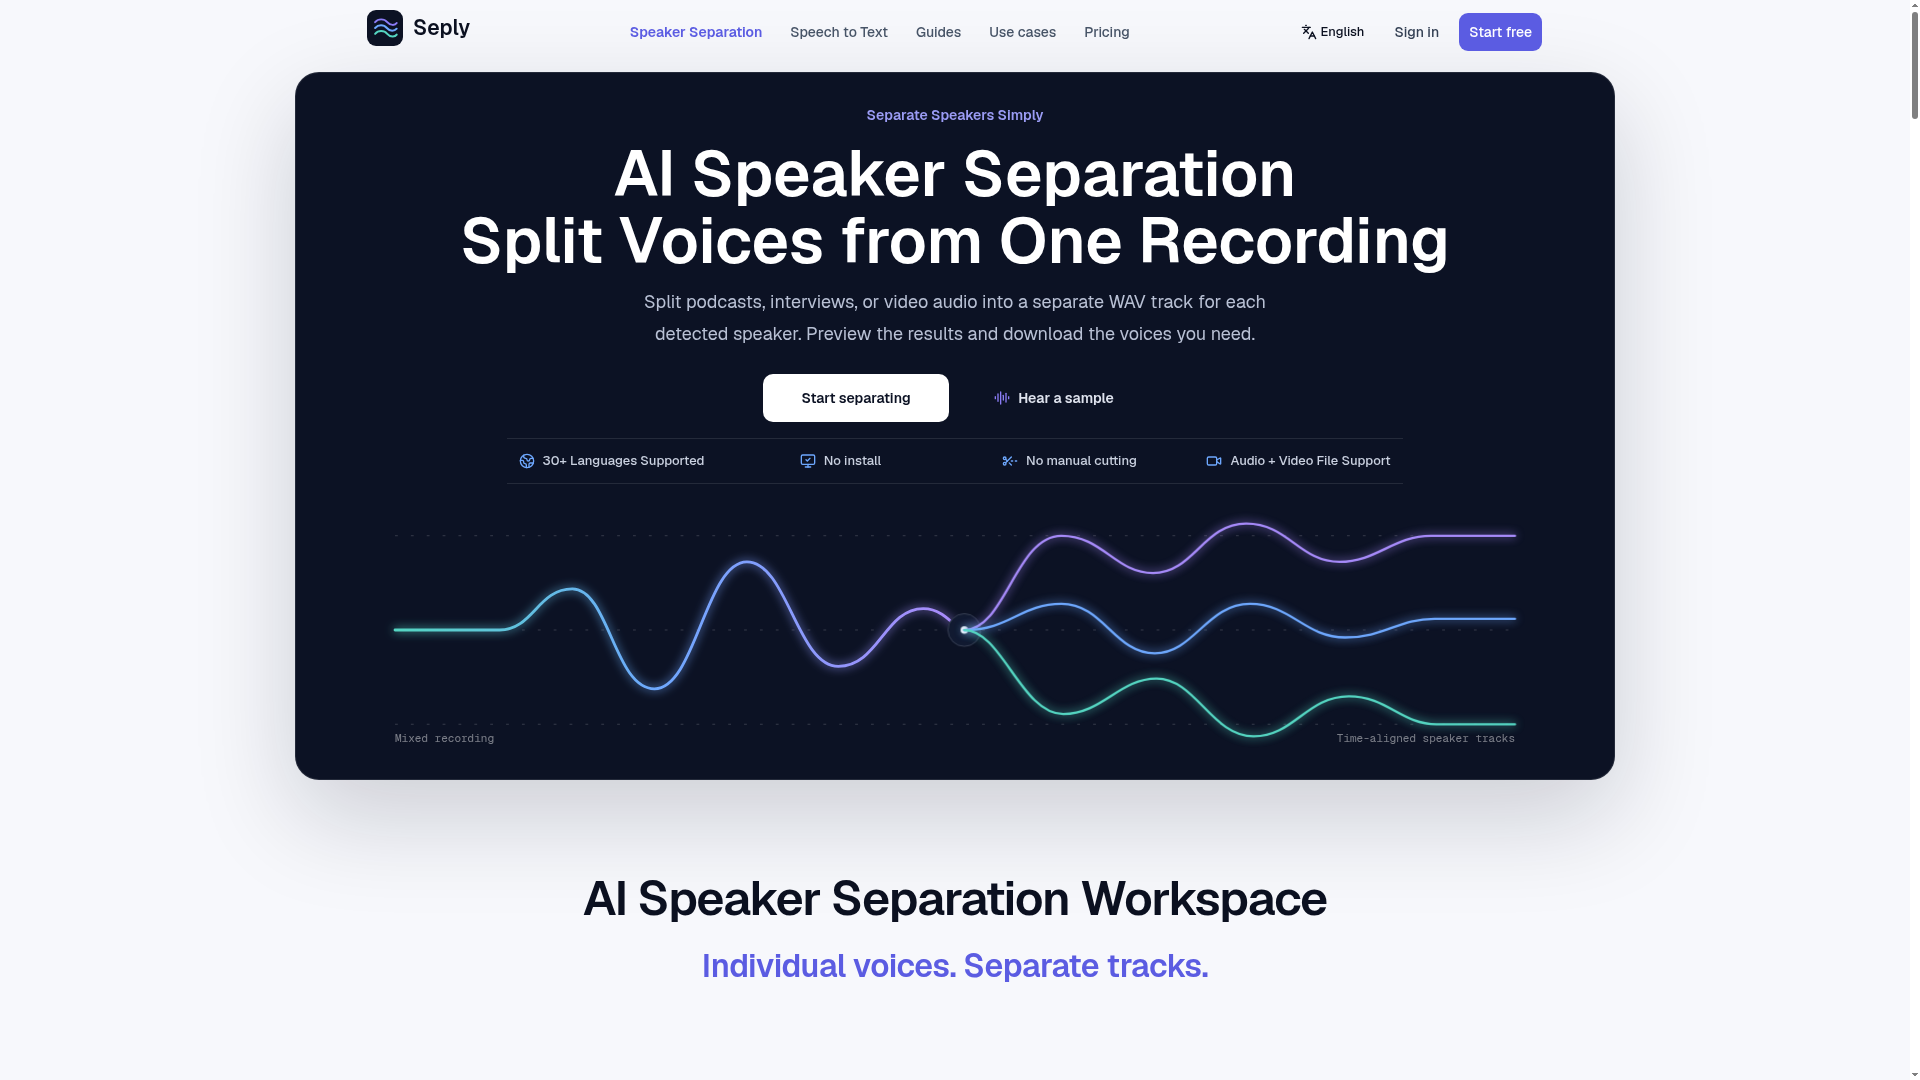
AI Speaker Separation 介绍
什么是AI说话人分离?
AI说话人分离是一项复杂的技术,它利用人工智能自动识别并分离单个音频或视频录制文件中的不同人声。它能将混合文件(如播客片段、采访或会议录音)转换为每个独立说话人的高质量WAV音轨。此过程也称为源分离或对话隔离。该技术通过分析音频的频谱和时间模式来区分不同人声,有效地“解开”对话。对于需要更高效、更可控地编辑、转录或复用多说话人内容的音频专业人士、播客制作者、记者和内容创作者而言,此工具至关重要。
AI说话人分离的主要功能
AI说话人分离集成了多项功能,旨在简化复杂的音频编辑任务。
-
独立说话人音轨:核心功能是为录音中检测到的每个说话人生成一条独立、可编辑的音频轨道,允许进行独立的音量调整、效果应用或移除。
-
时间对齐输出:所有分离出的音轨都与原始录音的时间线完美同步。这确保了导入音频或视频编辑器时,每个人声都在完全相同的时刻开始,保持了对话的自然流畅度和时序。
-
自动说话人检测:AI自动计数并识别不同的说话人。用户也可以手动指定预期的说话人数量,以便在复杂场景中可能获得更准确的结果。
-
广泛的文件格式支持:该服务接受多种音频(WAV、MP3、M4A、AAC、FLAC)和视频文件(MP4、MOV、AVI、MKV),提取并处理音频轨道,且不影响原始视频。
-
编辑器就绪的WAV下载:输出采用未压缩、高保真的WAV格式,这是专业音频编辑和后期制作工作流程的行业标准。
-
预览功能:在下载前,用户可以在平台内试听每条分离出的音轨,以验证准确性,并仅选择所需的人声。
-
高级重叠模式:提供专门的处理模式,以更好地处理说话人相互重叠的挑战性音频,尽管可能仍会残留一些串音。
如何使用AI说话人分离
使用AI说话人分离工具是一个简单的三步过程。
-
上传录音:登录平台并上传您的音频或视频文件。系统支持最大1 GB的文件,并会自动从视频文件中提取音频。
-
启动分离:上传后,启动AI处理。系统将分析文件,检测说话人数量,并开始运行分离算法。处理时间根据文件长度和复杂程度而异。
-
预览并下载:处理完成后,您可以直接在浏览器中预览每条分离出的说话人音轨。审核后,您可以下载所有说话人的独立WAV文件,或仅为您的项目选择特定的音轨。
AI说话人分离的定价
定价通常基于积分系统,积分根据处理的音频时长消耗。计划针对不同的使用级别设计。
-
免费试用:大多数服务提供一次性试用(例如,30积分),允许用户处理一个短样本(例如,约3分钟)来测试技术。
-
订阅计划:月度或年度订阅提供定期分配的积分。
-
入门计划(例如,约12美元/月):适合偶尔使用,每月提供约20分钟的分离时长。
-
创作者计划(例如,约29美元/月):适合常规内容制作,每月提供约60分钟的分离时长。
-
工作室计划(例如,约65美元/月):为团队或高用量用户设计,每月提供150分钟以上的分离时长。年度计费通常包含大幅折扣。
-
-
按需购买积分:对于非定期用户,可以购买一次性积分包。这些积分通常在购买后12个月内有效,允许灵活、无订阅的使用。
-
积分消耗:标准说话人分离通常按音频的起始分钟数消耗固定积分(例如,10积分/分钟)。用于困难音频的更高级“重叠”模式每分钟消耗的积分显著更高(例如,60积分/分钟)。
AI说话人分离实用技巧
为了从AI说话人分离中获得最佳效果,请考虑以下实用技巧。
-
从高质量录音开始:AI在清晰、高质量的源音频上表现最佳。背景噪音、回声和失真最少的录音将产生更干净的分离结果。
-
用于语音,而非音乐:该技术专门设计用于分离人声。它并非设计用于从歌曲中分离人声与乐器。
-
明确您的目标:确定您是需要用于编辑的完全分离的音频轨道(说话人分离),还是仅仅需要带有说话人标签的转录稿(说话人日志+转录)。这是不同的服务。
-
下载前预览:始终使用平台内的预览功能试听分离出的音轨。这可以确保AI正确识别了说话人,并且分离效果足以满足您的需求。
-
管理重叠预期:对于大量同时说话的对话,请使用“高级重叠”模式(如果可用)。请注意,在严重串音中实现完美分离具有挑战性,可能会出现来自其他说话人的一些串扰。
-
利用免费试用:在承诺付费计划之前,使用免费试用积分处理一个代表您典型工作的样本。这有助于您评估输出质量并估算每月积分需求。
常见问题
AI真的能分离用单个麦克风录制的两个人声吗?
是的,这是其主要功能。利用在多样化语音模式上训练的先进机器学习模型,AI可以区分不同的说话人,即使是在单个声道上录制的,也能为每个说话人输出独立的音轨。
说话人分离和说话人日志有什么区别?
说话人分离为每个说话人创建独立、可编辑的音频轨道(WAV文件)。说话人日志仅提供标注了“谁在何时说话”的转录稿,而不创建独立的音频文件。分离用于编辑音频;日志用于分析转录稿。
我分离出的文件在线存储多久?
通常,您上传的原始文件和分离出的音轨会在平台的服务器上私密存储有限的时间(通常为30天)。在此期间您可以随时下载。之后,媒体文件会被删除,但任务元数据可能保留。
我需要用语音样本来训练AI吗?
不需要。现代的AI说话人分离工具是“零样本”或“少样本”的,意味着它们无需任何先前的训练或您的语音样本,就能识别并分离未见过的说话人。上传后即可自动工作。
如果分离任务失败会怎样?
如果处理任务因服务器错误或不支持的文件而失败,为该任务预留的积分通常会退还到您的账户,并保留其原始到期日。
我可以用这个来只分离一个人的声音并移除所有其他人声吗?
可以。您需要运行完整的分离过程,该过程会为所有检测到的说话人创建音轨。然后,您只需预览结果,识别包含目标说话人的音轨,并仅下载那个单一的WAV文件,从而有效地分离出那个声音。
 Vercel